- Tomé indexou 2,3 milhões de documentos baixados diretamente da CVM
- Base tem 277 milhões de linhas e 6.368 colunas estruturadas
- Sistema roda 144 esteiras automáticas com 201 execuções diárias
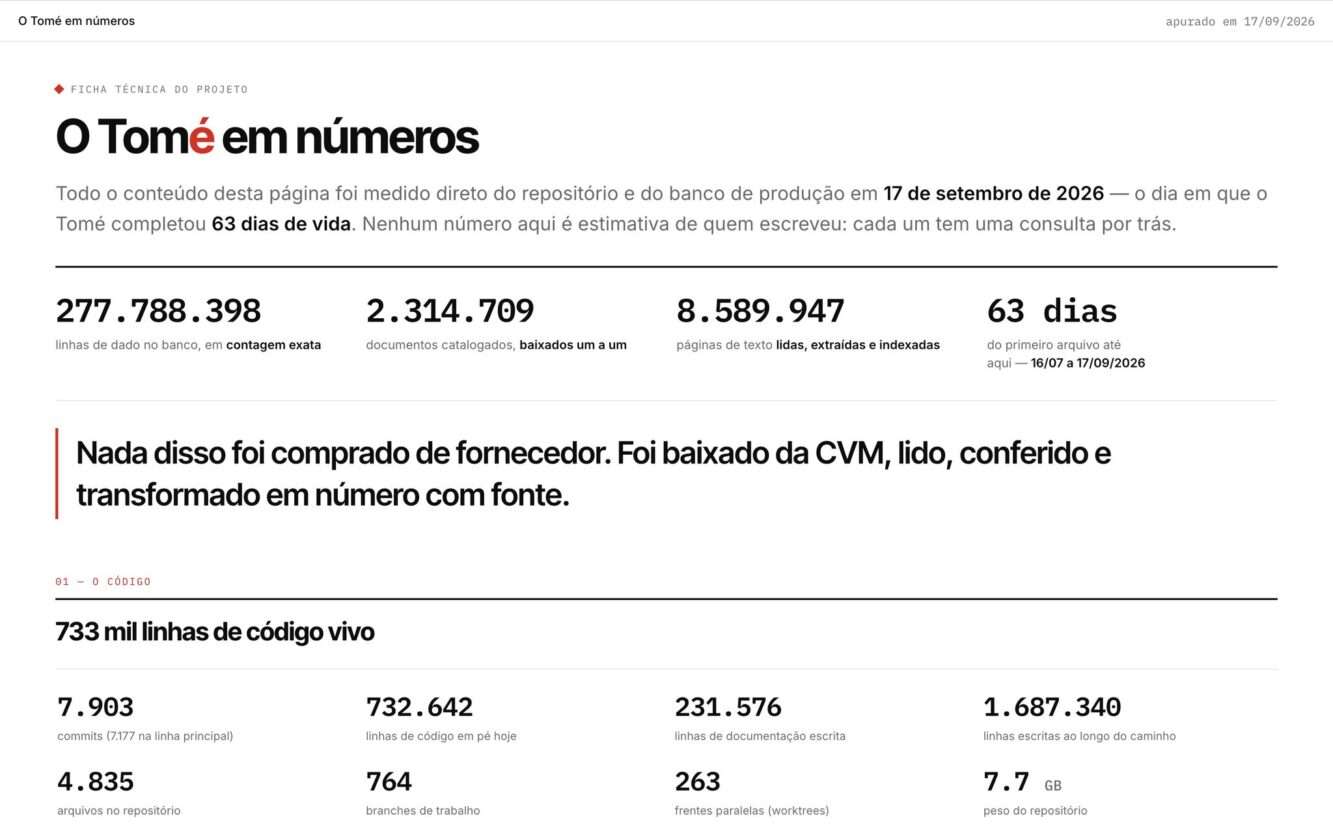
A inteligência artificial da Liqi, batizada de Tomé, chegou aos 63 dias de desenvolvimento com um acervo de 2,3 milhões de documentos da Comissão de Valores Mobiliários (CVM). Segundo levantamento divulgado por Daniel Coquieri, a ferramenta já havia lido, extraído e indexado aproximadamente 8,6 milhões de páginas, reunindo informações para consultas por meio de uma interface de conversa.
Os números, apurados em 17 de setembro de 2026, incluem 277,8 milhões de linhas de dados e 39.217 fundos com série histórica. De acordo com a publicação, as métricas foram obtidas diretamente do banco de produção e do repositório de código do projeto.
- Leia também: Cansado do Brasil? Liberland, nação 100% cripto, já recebeu 800 mil pedidos de cidadania
A proposta do Tomé é transformar documentos públicos em informações estruturadas, que possam ser cruzadas e comparadas. Para isso, o sistema processa materiais como regulamentos de fundos, atas de assembleia, pareceres de auditores e informes digitalizados.
“Nada disso foi comprado de fornecedor. Foi baixado da CVM, lido, conferido e transformado em número com fonte”, afirmou Coquieri.
Segundo Coquieri, a principal etapa do trabalho acontece antes de o usuário fazer uma pergunta. O sistema precisa extrair informações de documentos que apresentam diferentes formatos e organizar seu conteúdo em campos que permitam consultas.
A publicação informa que o projeto conta com 825.515 PDFs originais e 6.368 colunas de dados preparadas para cruzamentos, comparações e rankings. O acervo também inclui 224.807 arquivos XML estruturados.
Coquieri descreve esse processamento como o centro da ferramenta. A interface de conversa funciona como o ponto de acesso ao conteúdo organizado nos bastidores.
“O trabalho difícil acontece antes de qualquer pergunta: ler documento que nunca foi feito para máquina nenhuma ler — regulamento, ata de assembleia, parecer de auditor, informe digitalizado — e extrair dali dado estruturado, campo a campo, com a fonte presa a cada número”, escreveu.
Essa vinculação entre informação e documento original é uma das características destacadas no material. Segundo a ficha técnica, o usuário pode chegar ao PDF de origem de cada número apresentado pelo Tomé, permitindo conferir o conteúdo usado na resposta.
- Leia também: ETFs na B3 chegam a 862 mil CPFs e miram 1 milhão
Acervo reúne 8,6 milhões de páginas e dados de 39 mil fundos
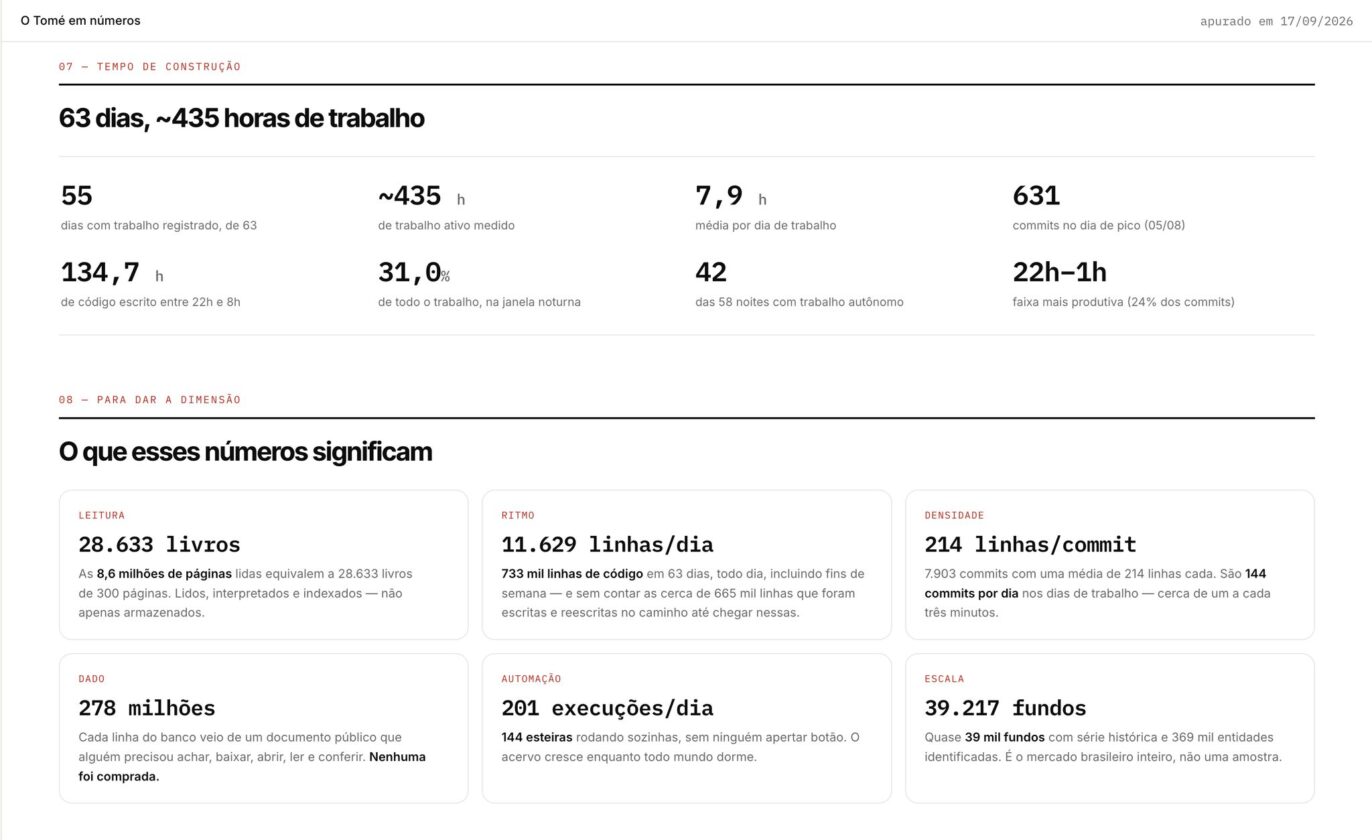
O levantamento registra, em números exatos, 2.314.709 documentos catalogados e 8.589.947 páginas de texto extraídas. A comparação apresentada pela empresa equivale esse volume a aproximadamente 28,6 mil livros de 300 páginas.
Além dos fundos com série histórica, o sistema contabiliza 369.283 entidades identificadas. O material também informa que os arquivos originais são preservados, mantendo a documentação disponível para consulta.
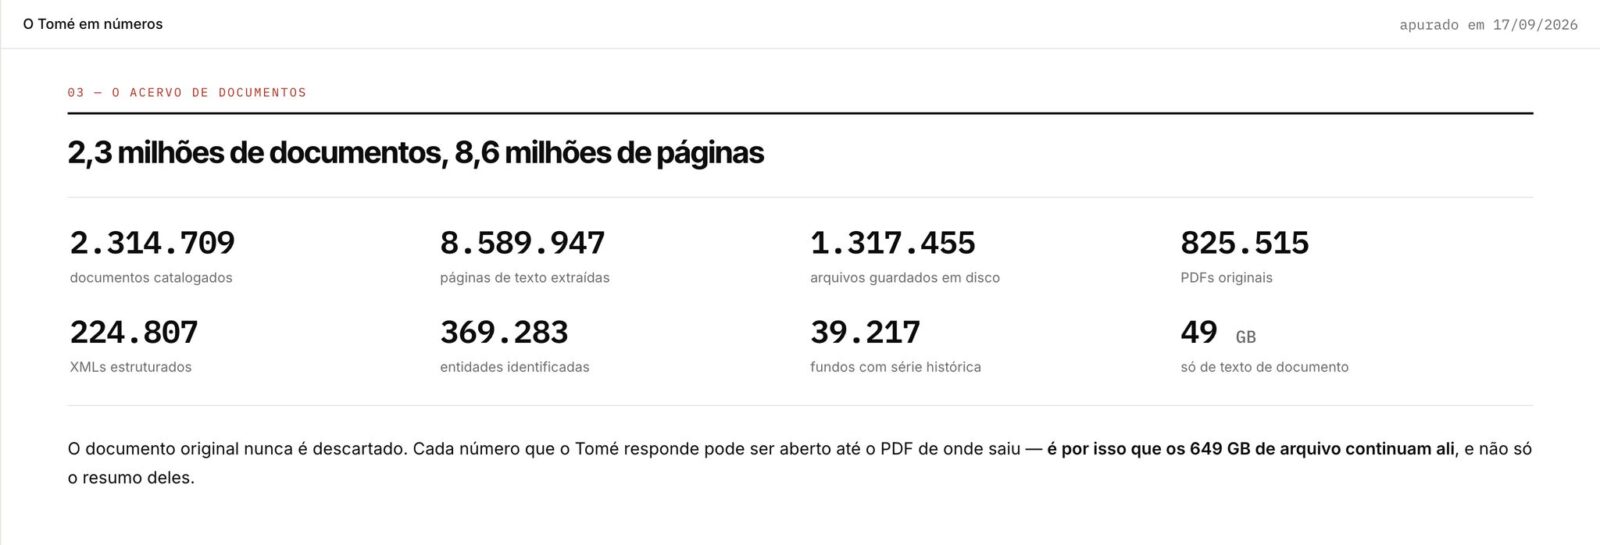
A ficha técnica distingue os diferentes componentes do acervo: documentos catalogados, arquivos armazenados, PDFs e páginas extraídas. Já as 277.788.398 linhas representam registros no banco de dados, e não o número de documentos reunidos.
As métricas descrevem a dimensão da base informada pela empresa. A publicação não apresenta um teste independente de precisão das respostas ou uma avaliação externa da qualidade das informações extraídas.
Processamento automático mantém a base em expansão
A operação conta, segundo Coquieri, com 144 esteiras automáticas de processamento e 201 execuções por dia. Esses fluxos funcionam sem acionamento manual a cada execução e dão continuidade ao trabalho sobre o acervo.
O desenvolvimento começou em 16 de julho de 2026. Na data do levantamento, o repositório reunia 732.642 linhas de código e 7.903 commits, registros das alterações realizadas no software.
- Leia também: Coinbase anuncia mudanças na Coinbase Wallet
Embora esses números mostrem o ritmo de construção informado pelo projeto, a proposta apresentada por Coquieri está na possibilidade de consultar documentos extensos por meio de dados organizados e rastreáveis.
“A conversa é só onde esse motor aparece”, resumiu.